Dataset Gambar Populer untuk Tolak Ukur Riset Pengenalan dan Deteksi Objek
1. Background
Object recognition dan object detection merupakan dua permasalahan fundamental dalam bidang computer vision. Object recognition bertujuan untuk menentukan apakah suatu objek dalam citra termasuk ke dalam class tertentu, sedangkan object detection tidak hanya mengklasifikasikan objek, tetapi juga menentukan lokasi objek tersebut di dalam citra. Lokasi objek umumnya direpresentasikan dalam bentuk bounding box.
Penggunaan dataset yang menantang sebagai benchmark memiliki peran yang sangat penting dalam penelitian computer vision. Dataset benchmark memungkinkan adanya perbandingan yang adil dan terstandarisasi antara berbagai algoritma, sekaligus menetapkan target performa yang jelas bagi metode-metode baru [1]. Tanpa adanya dataset benchmark yang disepakati bersama, evaluasi kinerja suatu metode akan sulit direproduksi dan kurang bermakna secara ilmiah.
Dalam beberapa dekade terakhir, dataset umum (general-purpose datasets) untuk object detection seperti PASCAL VOC, MS COCO, dan ImageNet telah menjadi arus utama (mainstream) dalam penelitian object detection dan object recognition. Dataset-dataset ini tidak hanya menyediakan jumlah citra yang besar, tetapi juga anotasi yang kaya dan beragam, sehingga mampu merepresentasikan kompleksitas dunia nyata secara lebih baik.
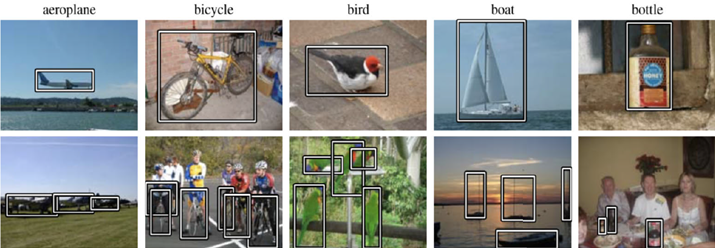
Gambar 1. Ilustrasi localization dan recognition objek menggunakan bounding box.
2. Dataset
A. PASCAL Visual Object Classes (VOC)
Background PASCAL Visual Object Classes (VOC) dataset merupakan salah satu dataset benchmark paling awal dan paling berpengaruh dalam penelitian object detection dan object recognition. Dataset ini dikembangkan melalui serangkaian tantangan (challenges) yang diselenggarakan secara tahunan dari tahun 2005 hingga 2012 [1].
- VOC 2005: memperkenalkan 4 object classes dan menjadi fondasi awal tantangan PASCAL.
- VOC 2007: salah satu versi yang paling banyak digunakan sebagai benchmark standar, dengan sekitar 5.000 citra untuk training dan lebih dari 12.000 objek beranotasi.
- VOC 2012: versi terakhir, dengan sekitar 11.000 citra training dan lebih dari 27.000 objek beranotasi.
Task
- Image classification
- Object detection
- Semantic segmentation
Classes Dataset ini terdiri dari 20 object categories.
Pembagian Dataset (VOC 2007)
- Train: 2.501 citra, 6.301 objek
- Validation: 2.510 citra, 6.307 objek
- Train-val: 5.011 citra, 12.608 objek
- Test: 4.952 citra, 12.032 objek
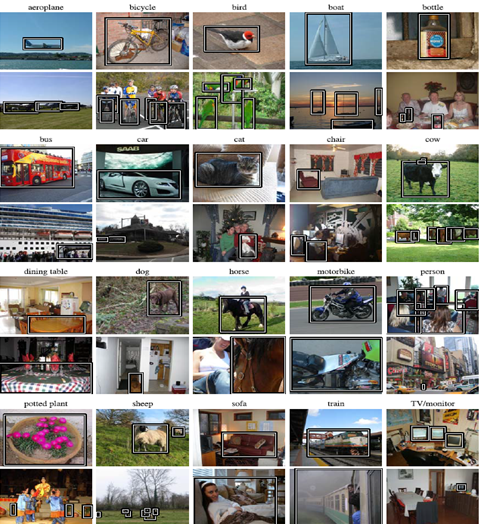
Gambar 2. Contoh anotasi dataset VOC 2007 untuk masing-masing dari 20 class.
B. MS COCO Dataset
Background Microsoft Common Objects in Context (MS COCO) dataset dirancang untuk mendeteksi dan melakukan segmentasi objek-objek yang sering dijumpai dalam kehidupan sehari-hari, dengan konteks lingkungan yang alami (in context) [2]. Dataset ini menargetkan skenario dunia nyata dengan banyak objek kecil, tumpang tindih (overlapping), dan latar belakang yang kompleks.
Task
- Object detection
- Instance segmentation
- Keypoint detection
- Image captioning
Classes Dataset ini mencakup 80 object categories.
Jumlah Data Total dataset MS COCO terdiri dari sekitar 328.000 citra.
Detail Rilis Dataset
- COCO 2014: Training 82.783, Validation 40.504, Test 40.775
- COCO 2015: Training 165.482, Validation 81.208, Test 81.434
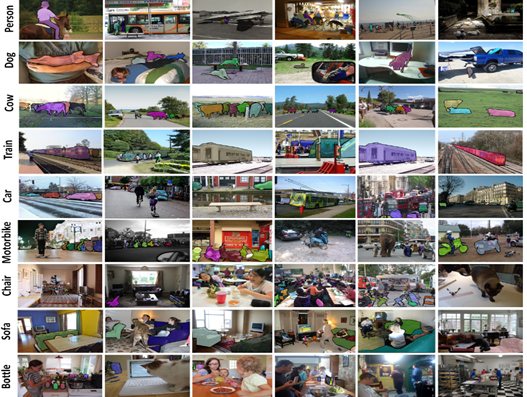
Gambar 3. Contoh citra dan anotasi pada MS COCO dataset.
C. ImageNet Dataset
Background ImageNet merupakan dataset berskala sangat besar yang dirancang untuk mendorong kemajuan dalam visual recognition melalui ImageNet Large Scale Visual Recognition Challenge (ILSVRC) [3]. Dataset ini disusun berdasarkan struktur WordNet dan mencakup ribuan object categories.
Task
- Image classification
- Object localization
Classes
- Lebih dari 20.000 categories secara keseluruhan
- 1.000 object classes pada subset ILSVRC
Detail Dataset
- ±1,2 juta citra training
- 50.000 citra validation
- 100.000 citra test
ImageNet berperan penting dalam mendorong perkembangan deep learning, khususnya convolutional neural networks (CNN), dan sering digunakan sebagai dataset pretraining.
D. Open Images Dataset
Background Open Images Dataset dikembangkan oleh Google untuk menyediakan dataset berskala besar dengan anotasi yang kaya, mencakup image-level labels, bounding boxes, dan visual relationships [4].
Task
- Image classification
- Object detection
- Visual relationship detection
Classes
- Lebih dari 600 object classes untuk object detection
Detail Dataset Dataset ini mencakup jutaan citra dengan anotasi bounding box dalam jumlah yang sangat besar, sehingga sangat relevan untuk riset object detection skala besar.
E. CIFAR-10 Dataset
Background CIFAR-10 merupakan dataset klasik yang banyak digunakan dalam penelitian awal image classification [5]. Dataset ini sering dijadikan baseline untuk evaluasi arsitektur dan algoritma baru.
Task
- Image classification
Classes
- 10 object classes
Detail Dataset
- Total 60.000 citra berwarna
- Ukuran citra: 32 × 32 piksel
- Training: 50.000 citra
- Test: 10.000 citra
3. Penutup
Dataset benchmark memainkan peran krusial dalam perkembangan riset object recognition dan object detection. PASCAL VOC menyediakan fondasi evaluasi terstandarisasi, MS COCO menawarkan skenario dunia nyata yang kompleks, ImageNet mendorong pembelajaran representasi visual skala besar, Open Images menghadirkan anotasi yang sangat kaya, dan CIFAR-10 menjadi benchmark klasik untuk evaluasi awal. Pemilihan dataset yang tepat sangat bergantung pada tujuan riset dan kompleksitas task yang ingin diselesaikan.
Referensi
[1] M. Everingham, L. Van Gool, C. K. I. Williams, J. Winn, and A. Zisserman, “The PASCAL Visual Object Classes (VOC) Challenge,” International Journal of Computer Vision, vol. 88, no. 2, pp. 303–338, 2010. [Online]. Available: https://doi.org/10.1007/s11263-009-0275-4
[2] T.-Y. Lin et al., “Microsoft COCO: Common Objects in Context,” in Proceedings of the European Conference on Computer Vision (ECCV), 2014. [Online]. Available: https://doi.org/10.1007/978-3-319-10602-1_48
[3] J. Deng et al., “ImageNet: A Large-Scale Hierarchical Image Database,” in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2009. [Online]. Available: https://doi.org/10.1109/CVPR.2009.5206848
[4] A. Kuznetsova et al., “The Open Images Dataset V4: Unified Image Classification, Object Detection, and Visual Relationship Detection at Scale,” International Journal of Computer Vision, vol. 128, pp. 1956–1981, 2020. [Online]. Available: https://doi.org/10.1007/s11263-020-01316-z
[5] A. Krizhevsky, “Learning Multiple Layers of Features from Tiny Images,” Technical Report, University of Toronto, 2009. [Online]. Available: https://www.cs.toronto.edu/~kriz/cifar.html